Moderiai atrakino RTX 20, RTX 30 ir RTX 40 serijų AI spartą
Modderiai surado būdų, kaip pašalinti „NVIDIA“ nustatytus skaičiavimo našumo apribojimus keliose „GeForce“ vaizdo plokščių kartose. Tai, kas prasidėjo nuo RTX 3090 serijos, dabar išsiplėtė iki RTX 40 modelių ir net senesnės RTX 2080 Ti.
Šios modifikacijos gali beveik dvigubai padidinti tam tikrų „Tensor Core“ operacijų našumą, nekeičiant aparatinės įrangos ir neperrašant naujo VBIOS. Tačiau tai nereiškia, kad žaidimų našumas padvigubės, o „GeForce RTX 50 Blackwell“ serijai dar nėra patvirtinto veikiančio atrakinimo būdo.
Šie tyrimai remiasi ankstesniais bandymais atrakinti apribotas skaičiavimo galimybes „NVIDIA“ CMP serijoje. Kūrėjas Zagitta pritaikė šias technikas „GeForce RTX 30“ plokštėms per atviro kodo projektą „GPU-Unlock“, o darbas su TOTORONG programinės įrangos modulu išplėtė palaikymą „Ada“ architektūrai.
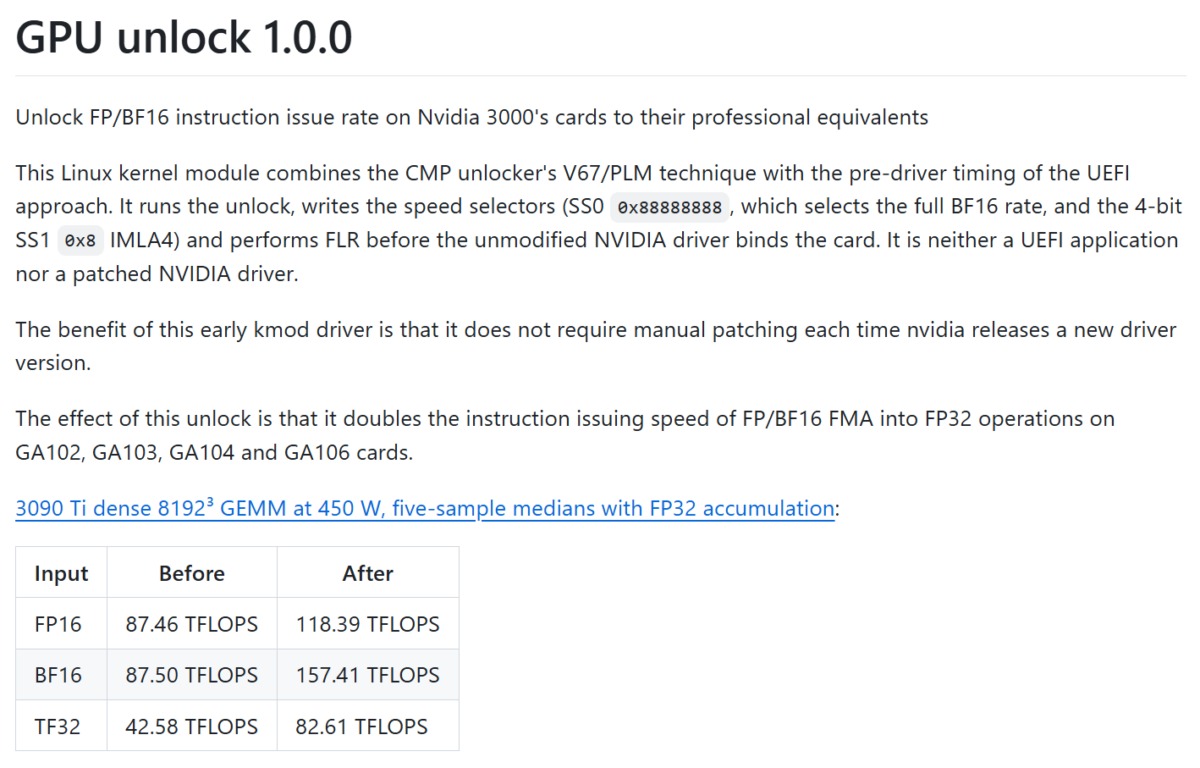
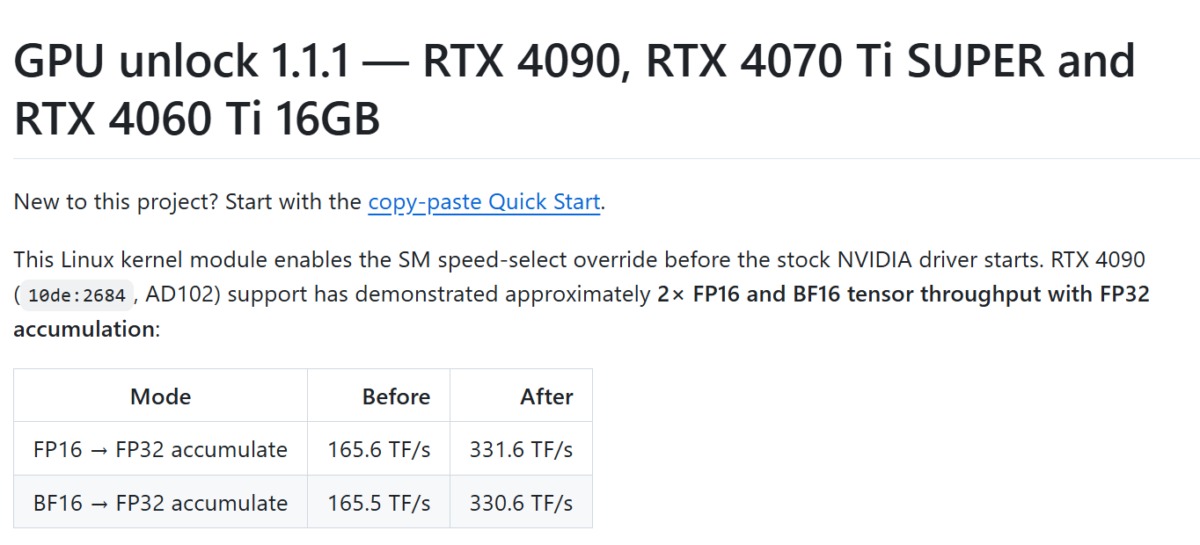
Vietoj grafikos tvarkyklių modifikavimo, šie įrankiai keičia žemo lygio GPU konfigūracijos registrus prieš įkeliant „NVIDIA“ tvarkyklę, pašalindami apribojimus, susijusius su tam tikrų „Tensor Core“ instrukcijų vykdymu. Šie pakeitimai yra laikini ir ištrinami, kai GPU netenka maitinimo.
Pateikti rezultatai yra reikšmingi atliekant konkrečius skaičiavimo testus. RTX 3090 Ti padidino BF16 matricos našumą nuo 87,5 iki 157,4 TFLOPS, o RTX 4090 padvigubino išmatuotą FP16 „Tensor Core“ instrukcijų pralaidumą nuo 165,6 iki 331,6 TFLOPS. „KohakuBlueleaf“ taip pat pademonstravo, kad RTX 2080 Ti pasiekė 111 TFLOPS, palyginti su 59,9 TFLOPS prieš atrakinimą. Ši konkreti plokštė jau buvo fiziškai modifikuota, turėdama 22 GB VRAM, o tai nesusiję su programiniu atrakinimu. Taip pat pranešta apie sėkmingus bandymus su RTX 3060, RTX 3070, RTX 3080 ir pasirinktomis RTX 40 serijos plokštėmis, nors palaikymas dar nėra patvirtintas visų GPU variantų atžvilgiu.
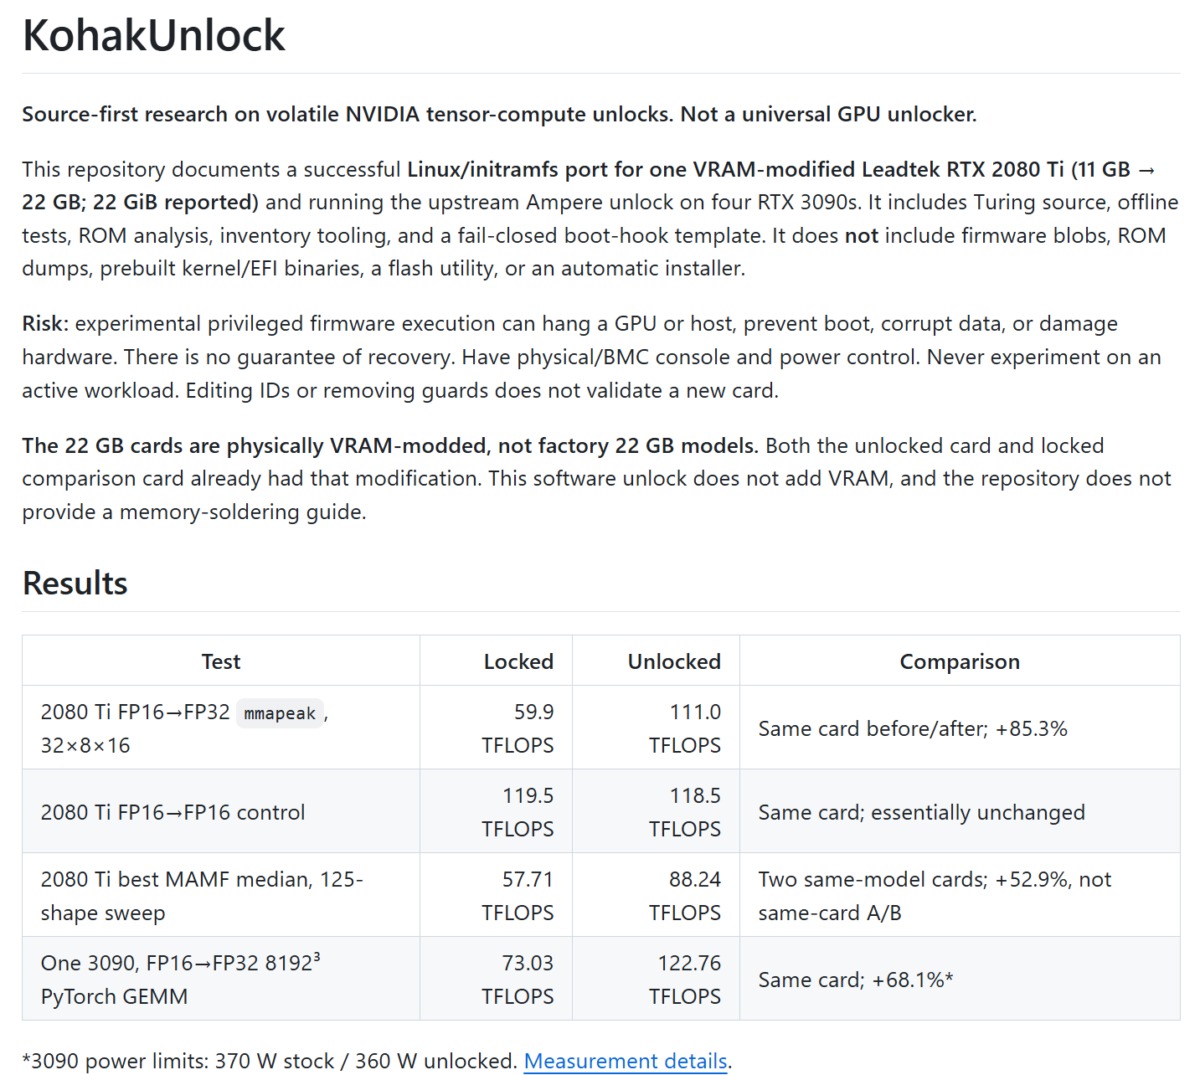
Šie pakeitimai pirmiausia veikia FP16 ir BF16 operacijas su FP32 kaupimu, taip pat tam tikras TF32 ir FP8 darbo apkrovas palaikomose architektūrose. Jie gali pagreitinti AI užduotis, susijusias su matricos daugyba, įskaitant LLM užklausų apdorojimą ir kai kurias vaizdų generavimo užduotis.
Tačiau faktinis našumo padidėjimas priklauso nuo naudojamos programinės įrangos. RTX 3090 ataskaitos rodo, kad LLM užklausų apdorojimas pagerėjo maždaug nuo 14 % iki 36 %, o žetonų generavimas iš esmės nesikeičia, nes jį dažnai riboja atminties pralaidumas. Šios konkrečios modifikacijos neturi įtakos žaidimų našumui. Dauguma projektų šiuo metu skirti „Linux“ sistemai, nors taip pat yra eksperimentinių „Windows“ įgyvendinimų. Jie nėra visiškai be rizikos, o nepalaikomos konfigūracijos gali nesikrauti.
 Loading ...
Naujausi komentarai